Rechnungen, Anträge, Arztbriefe, Kündigungen: Jedes eingehende Dokument muss an die richtige Stelle. Wer von Hand sortiert, bindet Menschen, die anderswo gebraucht werden. Diesen Schritt übernimmt die PDF-Klassifikation.
Was ist PDF-Klassifikation?
PDF-Klassifikation ordnet jedes eingehende Dokument automatisch einer Klasse zu. Die Klassen legen Sie selbst fest, ob zehn oder mehrere hundert. Die Software liest Inhalt und Layout des Dokuments und ordnet es einer Klasse zu.
Das funktioniert mit Scans und Fotos (PNG, JPEG) genauso wie mit PDFs.
Wo die Klassifikation im Ablauf steht
Zuerst liest die Texterkennung das Dokument. Dann entscheidet die Klassifikation, um welche Art Dokument es sich handelt. Danach holt die Extraktion die benötigten Daten heraus, etwa Rechnungsnummer oder Datum. Die Ergebnisse gehen an Ihr ECM- oder Dokumentenmanagementsystem.
Die Klassifikation ist die Weiche in der Mitte. Sortiert sie falsch, arbeitet jeder folgende Schritt mit dem falschen Dokument.
Drei Wege zu klassifizieren
| Weg | Stärke | Schwäche |
|---|---|---|
| Von Hand | Menschen erkennen auch Unvorhergesehenes | Langsam und ermüdend bei großen Mengen |
| Mit Regeln | Schnell und einheitlich bei bekannten Dokumenten | Jede neue Dokumentart braucht neue Regeln |
| Mit KI | Lernt aus Beispielen, passt sich neuen Arten an | Braucht eine erste Trainingsphase |
Regelbasierte Systeme scheitern oft schon an einem geänderten Layout. KI-Modelle lernen, wie eine Dokumentklasse aussieht, und erkennen sie auch im neuen Design.
Was sich in der Praxis ändert
Ein Scan-Dienstleister verarbeitet jedes Jahr eine Milliarde Seiten für Gesundheitswesen, öffentlichen Sektor und Unternehmen. Mit einem regelbasierten IDP-Produkt automatisierte er weniger als 50 % seiner Dokumentenklassifikation. Alles unter der Vertrauensschwelle musste von Hand geprüft werden.
Mit IDA lag die Automatisierungsrate von Anfang an bei über 90 %. Die Einrichtung dauerte weniger als drei Tage. Die vorherige Lösung hatte 240 gebraucht.
Als neue Vorschriften kamen, wuchs die Zahl der Dokumentklassen von rund 150 auf über 300. IDA lernte die neuen Klassen aus wenigen Beispielen. Der manuelle Aufwand sank um 80 %, die Fehlzuordnungen blieben unter 1 %.
Wo PDF-Klassifikation eingesetzt wird
Finanzwesen und Buchhaltung
Rechnungen, Quittungen und Kontoauszüge werden erkannt und an die Buchhaltung weitergegeben.
Gesundheitswesen
Patientenakten, Befunde und Rezepte werden getrennt und in der richtigen Akte abgelegt.
Öffentliche Verwaltung
Eingehende Schreiben, Anträge und Bescheide landen beim zuständigen Fachbereich.
E-Mail-Postfach
PDF-Anhänge wie Rechnungen oder Tickets werden erkannt und sortiert, sobald sie eingehen.
Typische Stolpersteine
Manche Dokumentklassen sehen fast gleich aus. Kündigung und Vertragsänderung kommen manchmal auf demselben Formular. Hier reicht das Layout allein nicht. IDA liest auch den Inhalt.
Scans sind unterschiedlich gut. Blasse Kopien, schiefe Seiten und Stempel erschweren die Erkennung. Die Klassifikation ist nur so gut wie die Texterkennung darunter.
Layouts ändern sich. Gestaltet eine Versicherung ihre Formulare neu, müssen Regelwerke nachgebaut werden. Ein trainiertes Modell erkennt die neue Fassung an wenigen Beispielen.
IDA Classification
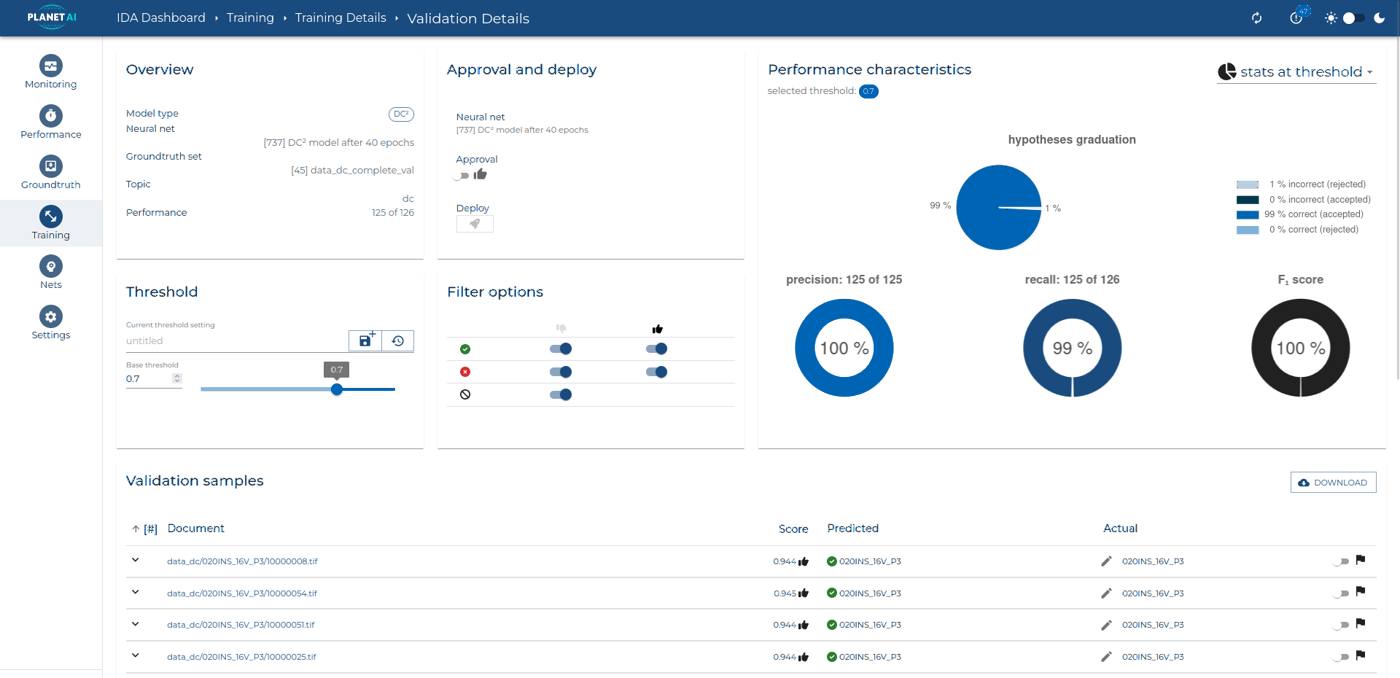
IDA Classification lernt aus Beispielen, nicht aus festen Regeln. Neue Klassen können Sie jederzeit ergänzen. Jede Zuordnung bekommt einen Konfidenzwert. Sie legen fest, ab welchem Wert ein Dokument automatisch durchläuft.
Große PDFs enthalten oft viele Dokumente hintereinander. Document Splitting erkennt, wo ein Dokument endet und das nächste beginnt, und teilt die Datei.
Häufige Fragen
Was ist der Unterschied zwischen Klassifikation und Extraktion?
Die Klassifikation beantwortet die Frage „Was für ein Dokument ist das?“. Die Extraktion beantwortet „Welche Daten stehen darin?“. Die Klassifikation kommt zuerst, denn die Klasse bestimmt, welche Daten ausgelesen werden.
Wie viele Dokumentklassen sind möglich?
Die Klassen legen Sie selbst fest. Im Projekt mit dem Scan-Dienstleister sind es über 300.
Funktioniert das mit gescannten Dokumenten?
Ja. IDA klassifiziert Scans und Fotos ebenso wie digitale PDFs.
Was passiert, wenn die Software unsicher ist?
Jede Zuordnung hat einen Konfidenzwert. Liegt er unter der Schwelle, die Sie festlegen, prüft ein Mensch das Dokument.
Wie trenne ich ein PDF, in dem mehrere Dokumente stecken?
Mit Document Splitting. IDA erkennt Anfang und Ende jedes Dokuments und teilt die Datei entsprechend.
Mit Ihren Dokumenten ausprobieren
In einer Demo zeigen wir Ihnen, wie IDA Ihre Dokumente sortiert.