Ein gescanntes PDF sieht aus wie ein Dokument, für einen Computer ist es aber ein Bild. Man kann es nicht durchsuchen, nichts daraus kopieren und nichts weiterverarbeiten. Die Texterkennung macht aus dem Bild wieder Text.
Was ist PDF-Texterkennung?
Die PDF-Texterkennung liest den Text in einem gescannten oder fotografierten Dokument und speichert ihn als maschinenlesbaren Text. Die Seite sieht aus wie vorher, aber Sie können sie jetzt durchsuchen, daraus kopieren und an andere Systeme weitergeben.
Sie ist der erste Schritt in jedem automatisierten Dokumentenprozess. Sortieren, Auslesen und Prüfen hängen davon ab: Was am Anfang falsch gelesen wird, bleibt in jedem weiteren Schritt falsch.
OCR, ICR und HTR
| Begriff | Steht für | Liest |
|---|---|---|
| OCR | Optical Character Recognition, optische Zeichenerkennung | Maschinenschrift |
| ICR | Intelligent Character Recognition, intelligente Zeichenerkennung | Handschriftliche Druckbuchstaben und Ziffern, etwa in Formularfeldern |
| HTR | Handwritten Text Recognition, Handschrifterkennung | Fließende Handschrift, auch historische Schriften |
In der Praxis lassen sich die drei selten trennen: Ein Formular enthält gedruckte Beschriftungen, handschriftliche Einträge und Ankreuzfelder auf derselben Seite. IDA liest alles in einem Durchgang.
Was eine gute Texterkennung können muss
Schlechte Vorlagen
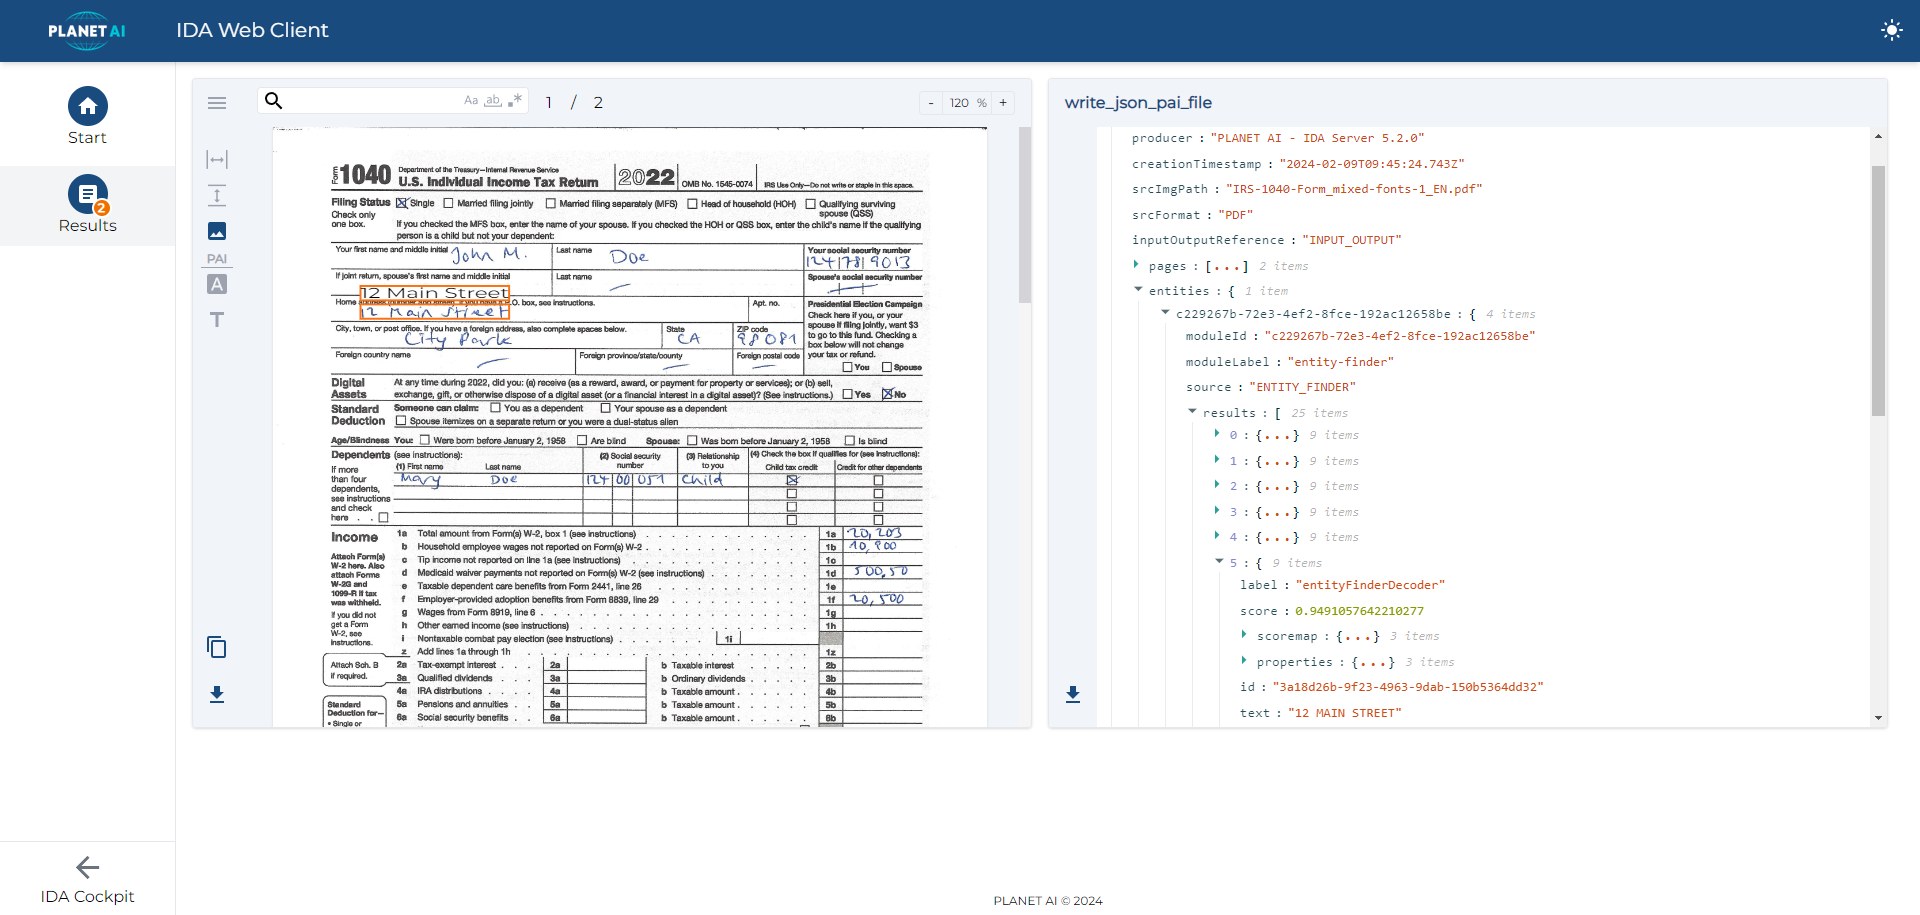
Blasse Scans, Faxe, Stempel über dem Text, schiefe Fotos. IDA liest Maschinenschrift mit einer Genauigkeit von über 99 %, auch aus schwierigen Vorlagen.
Handschrift
Handschriftliche Einträge sehen bei jedem Menschen anders aus. IDA erkennt Handschrift mit einer Genauigkeit von über 95 %, auch historische Schriften wie Kurrent. Mehr dazu in unserem Blogbeitrag zur Handschrifterkennung.
Layout und Lesereihenfolge
Spalten, Fußnoten, Kopfzeilen und Textkästen müssen in der richtigen Reihenfolge gelesen werden. Sonst landen Sätze an der falschen Stelle.
Tabellen
Zeilen und Spalten müssen Zeilen und Spalten bleiben, damit jeder Betrag bei der richtigen Position steht.
Was am Ende dabei herauskommt
- Ein durchsuchbares PDF: die Originalseite mit einer unsichtbaren Textebene. Menschen können es durchsuchen, daraus kopieren und im DMS ablegen.
- Text und Daten als JSON: für Systeme, die den Inhalt weiterverarbeiten. Mehr dazu in unserem Blogbeitrag zu PDF und JSON.
Ist der Text erkannt, können die nächsten Schritte automatisch folgen: Die Klassifikation sortiert das Dokument, die Datenextraktion liest die Werte aus.
Wo PDF-Texterkennung zum Einsatz kommt
Posteingang
Briefe, Formulare und E-Mail-Anhänge werden zu Text, der sich sortieren und verteilen lässt. Mehr dazu in unserem Blogbeitrag zum digitalen Posteingang.
Archive und historische Bestände
Akten, Kirchenbücher und Urkunden werden im Volltext durchsuchbar, auch wenn sie handschriftlich sind. Mehr zu IDA für Archive.
Scan-Dienstleister
Digitalisierungsprojekte liefern durchsuchbare Dokumente statt nur Bilder.
Öffentliche Verwaltung
Anträge und Nachweise, die auf Papier oder als Scan eingehen, werden für digitale Abläufe nutzbar.
Häufige Fragen
Was ist der Unterschied zwischen einem gescannten und einem durchsuchbaren PDF?
Ein gescanntes PDF enthält nur ein Bild der Seite. Ein durchsuchbares PDF hat zusätzlich eine unsichtbare Textebene, sodass Sie den Text durchsuchen und kopieren können.
Funktioniert die Texterkennung auch mit Handschrift?
Ja. IDA erkennt Handschrift mit einer Genauigkeit von über 95 %, in Formularfeldern ebenso wie in Fließtext.
Welche Formate kann IDA lesen?
PDF und Bildformate wie PNG und JPG, aus dem Scanner, aus E-Mail-Anhängen oder aus Uploads.
Verlassen die Daten unser Unternehmen?
Nicht, wenn Sie das nicht möchten. IDA läuft im eigenen Rechenzentrum, in einer souveränen Cloud oder hybrid.
Mit Ihren Dokumenten ausprobieren
In einer Demo zeigen wir Ihnen, wie IDA Ihre gescannten PDFs liest, auch schwierige Vorlagen und Handschrift.