Ein Scanner weiß nicht, wo ein Dokument endet. Er erzeugt eine Datei pro Stapel, und darin stecken vielleicht eine Rechnung, ein Lieferschein, drei Briefe und ein Vertrag. Bevor jemand damit arbeiten kann, müssen sie getrennt werden.
Was ist PDF-Trennen?
PDF-Trennen, auch Dokumententrennung genannt, teilt eine mehrseitige Datei in ihre einzelnen Dokumente auf. Jedes Dokument bekommt eine eigene Datei und lässt sich für sich klassifizieren, auslesen und ablegen.
Von Hand heißt das: durch die Datei blättern, die erste Seite jedes Dokuments erkennen und es heraustrennen. Bei großen Mengen dauert das Stunden, und Fehler schleichen sich ein.
Warum ein PDF oft viele Dokumente enthält
Eingangspost wird stapelweise gescannt. Anträge kommen mit allen Nachweisen in einem Anhang. Archive digitalisieren ganze Ordner auf einmal. In all diesen Fällen entsteht ein PDF mit vielen Dokumenten unterschiedlicher Art.
Trennblätter oder Barcodes zwischen den Dokumenten helfen, aber sie müssen vor dem Scannen von Hand eingelegt werden und fehlen bei E-Mails und Uploads meist ganz.
Wie IDA die Grenzen erkennt
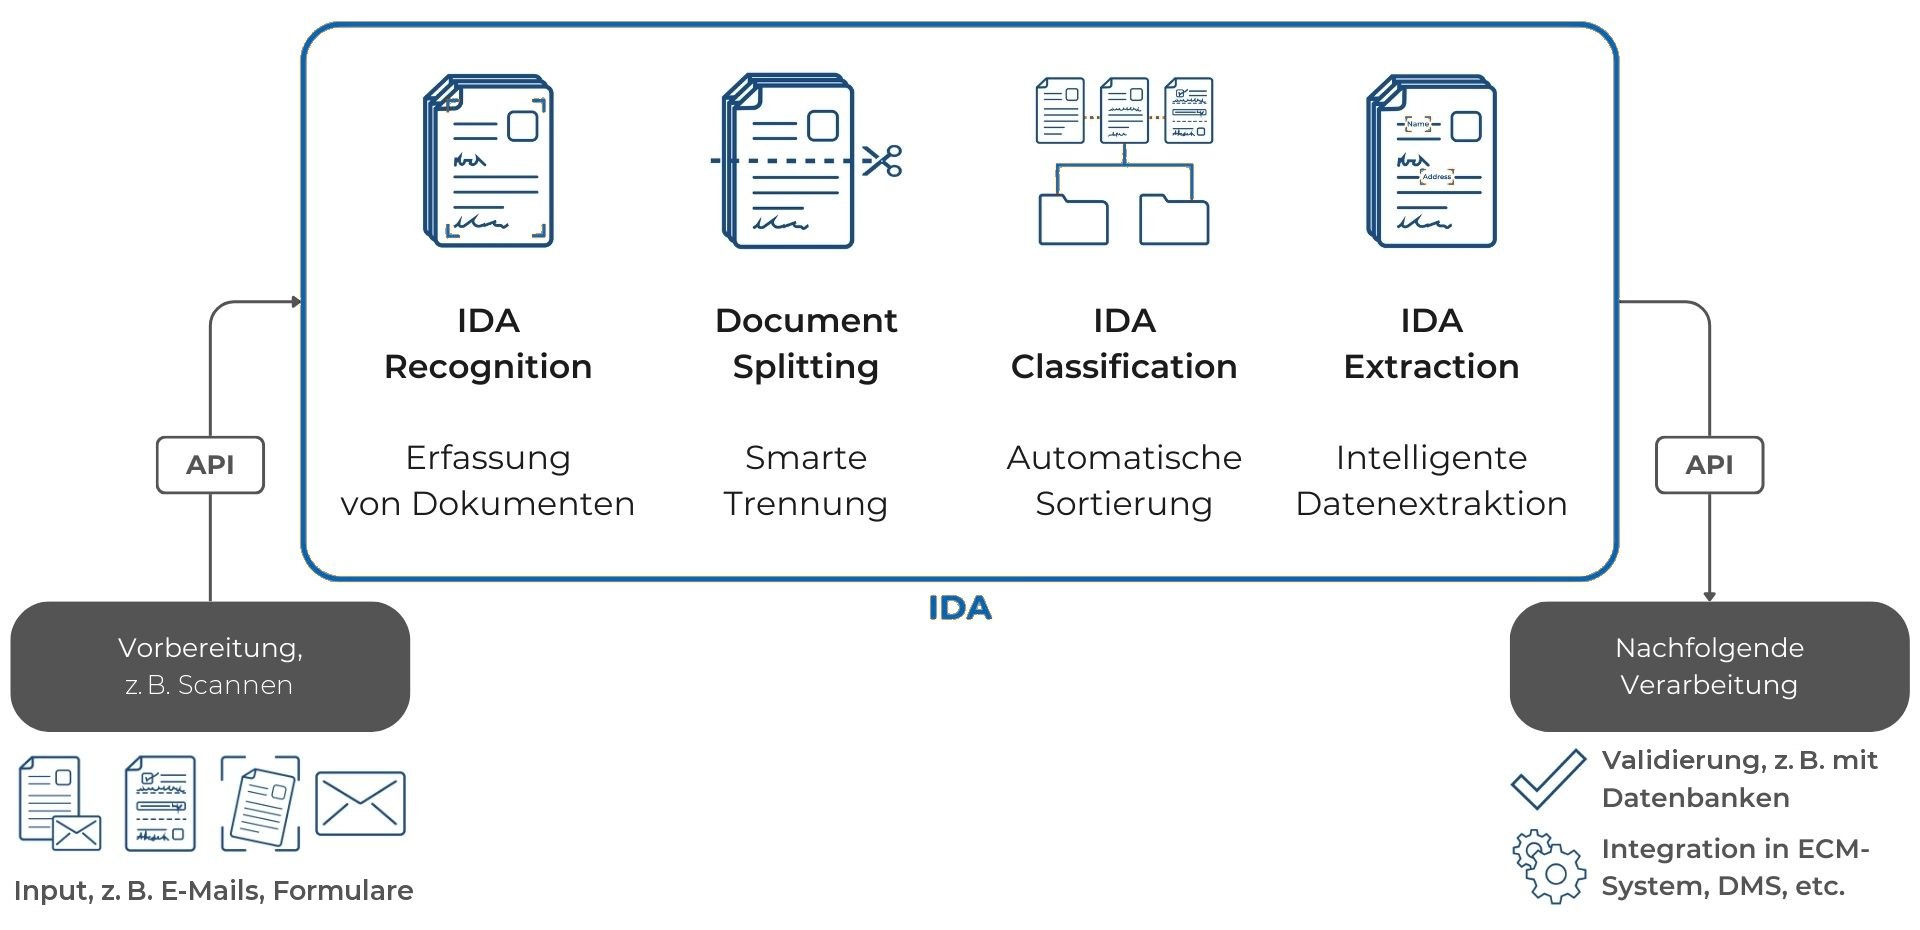
IDA liest zuerst jede Seite: Maschinenschrift mit einer Genauigkeit von über 99 %, Handschrift mit über 95 %. Dann erkennt IDA, wo ein neues Dokument beginnt, am Layout, am Inhalt und an typischen Merkmalen erster Seiten wie Briefkopf, Betreffzeile oder Formulartitel.
Jedes getrennte Dokument geht direkt weiter in die Klassifikation und das Auslesen. Mehr dazu in unseren Blogbeiträgen zur PDF-Klassifikation und zur Entity Extraction.
Was sich im Alltag ändert
Kein Sortieren von Hand
Niemand blättert mehr durch Stapel auf der Suche nach der ersten Seite des nächsten Dokuments.
Jedes Dokument im richtigen Prozess
Getrennt lässt sich jedes Dokument für sich klassifizieren und verteilen: die Rechnung in die Buchhaltung, der Vertrag in die Rechtsabteilung.
Bessere Daten
Das Auslesen arbeitet auf genau einem Dokument. Werte aus dem Lieferschein landen nicht in der Rechnung.
Schneller gefunden
Dokumente werden einzeln und richtig benannt abgelegt, nicht als Seite 14 bis 17 eines Scans.
Wo PDF-Trennen zum Einsatz kommt
Rechnungen
Aus einem Stapel gescannter Rechnungen werden einzelne Rechnungen, die sich einzeln prüfen und buchen lassen.
Kreditanträge
Antrag und Nachweise wie Gehaltsabrechnungen und Ausweise werden getrennt und einzeln geprüft.
Posteingang und Kundenservice
Briefe mit Anlagen werden getrennt, damit jedes Anliegen im richtigen Vorgang landet. Mehr dazu in unserem Blogbeitrag zum digitalen Posteingang.
Patientenakten
Befunde, Laborwerte und Arztbriefe werden einzeln in der richtigen Akte abgelegt.
Personal- und Fallakten
Umfangreiche Akten werden in ihre einzelnen Dokumente zerlegt und durchsuchbar gemacht.
Häufige Fragen
Was ist der Unterschied zwischen PDF-Trennen und Klassifikation?
Das Trennen findet, wo Dokumente beginnen und enden. Die Klassifikation bestimmt danach, welche Art von Dokument es ist. Beides arbeitet zusammen.
Brauchen wir noch Trennblätter?
Nein. IDA erkennt Dokumentgrenzen am Inhalt und am Layout.
Welche Dateiformate werden unterstützt?
PDF und Bildformate wie PNG und JPG, aus dem Scanner, aus E-Mail-Anhängen oder aus Uploads.
Was passiert, wenn eine Grenze unsicher ist?
IDA gibt jeder Entscheidung einen Konfidenzwert. Unter dem Schwellenwert, den Sie festlegen, prüft ein Mensch das Ergebnis.
Mit Ihren Dokumenten ausprobieren
In einer Demo zeigen wir Ihnen, wie IDA Ihre gescannten Stapel in einzelne Dokumente aufteilt.