In einem Brief stehen ein Name, eine Adresse, ein Datum und eine IBAN. Ein Mensch sieht das auf einen Blick. Für Software ist der Brief nur Text, bis die Entity Extraction ihr sagt, was was ist.
Was ist Entity Extraction?
Entity Extraction, auf Deutsch Entitätenextraktion, findet bestimmte Informationen in einem Text und benennt sie. Diese Informationen heißen Entitäten: Namen von Personen und Organisationen, Orte, Datumsangaben, Beträge, Vertrags- oder Kundennummern.
Das Ergebnis sind strukturierte Daten. Statt einer Seite Text erhalten Sie „Name: John Doe“, „Datum: 2. Februar 2021“, „IBAN: DE10…“. Damit arbeitet Geschäftssoftware direkt weiter. Mehr dazu in unserem Blogbeitrag zu strukturierten Daten.
Warum alles mit der Texterkennung beginnt
Die Entity Extraction findet nur, was die Texterkennung richtig gelesen hat. Ist eine Ziffer in der IBAN falsch, ist auch die ausgelesene IBAN falsch.
Deshalb beginnt IDA mit einer verlässlichen Texterkennung: Maschinenschrift mit einer Genauigkeit von über 99 %, Handschrift mit über 95 %. Mehr dazu in unserem Blogbeitrag zur Handschrifterkennung.
Formulare und Rechnungen: auslesen nach Beispielen
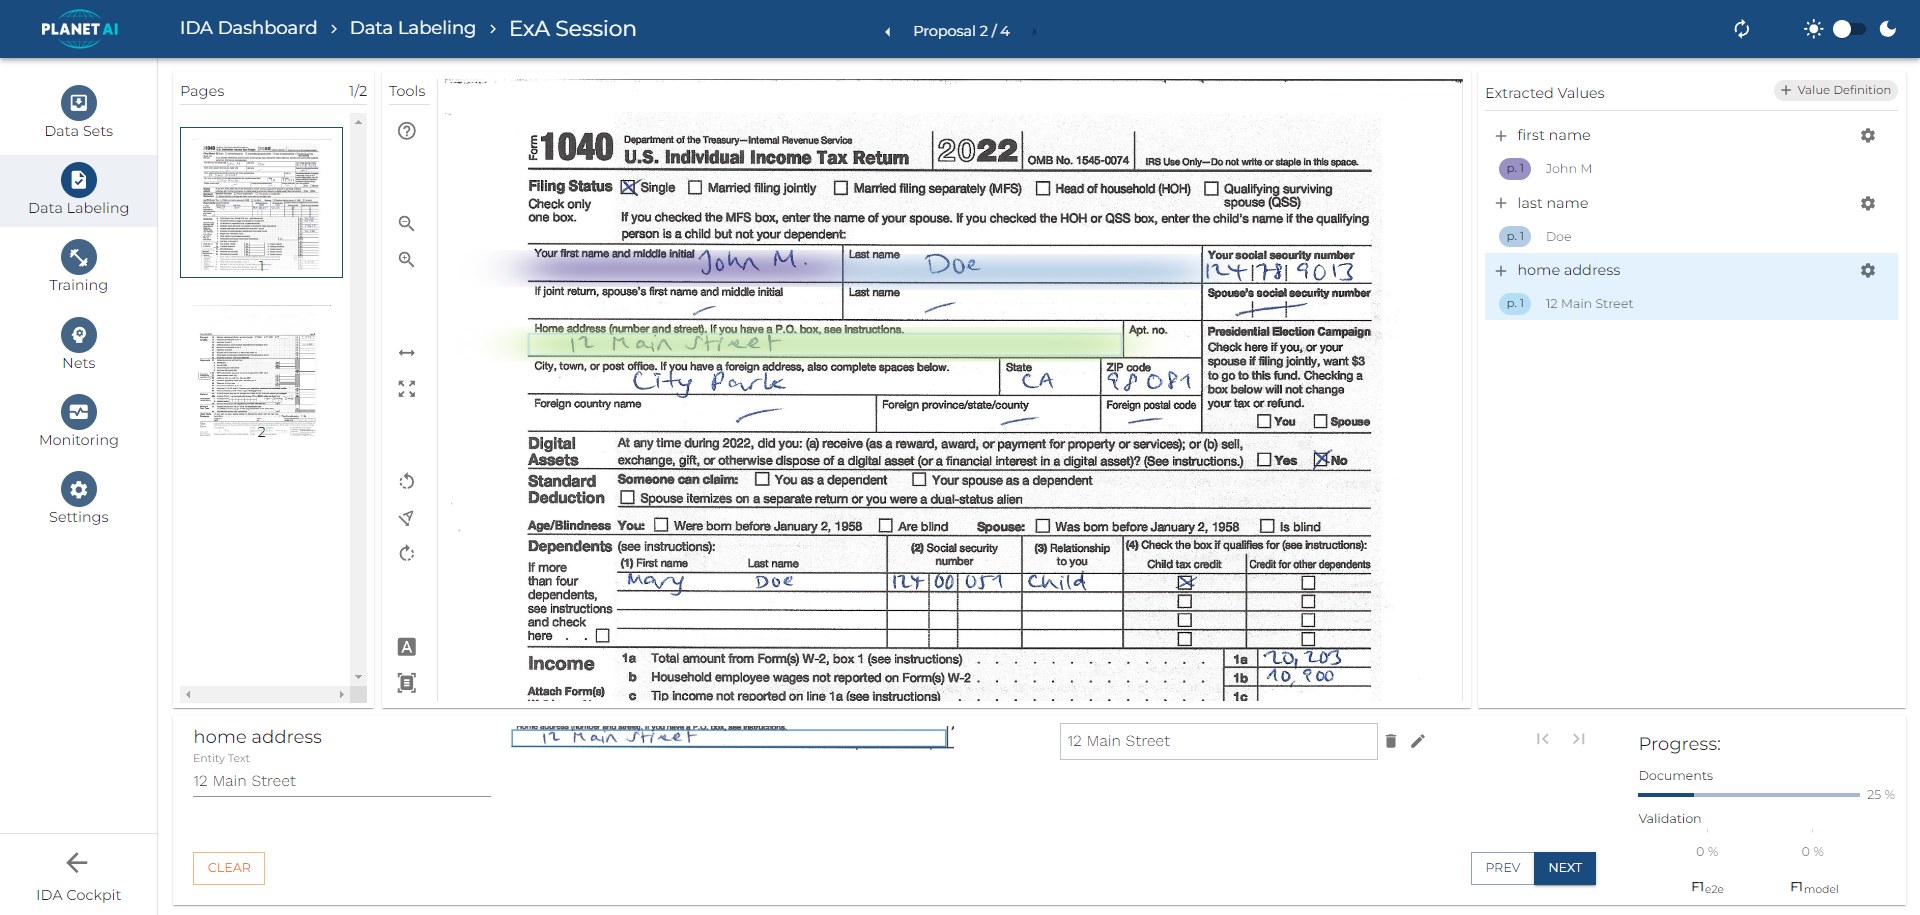
In Formularen und Rechnungen steht dieselbe Information meist an derselben Stelle. IDA lernt aus wenigen markierten Beispielen, wo. Sie markieren das Feld einmal, etwa „Adresse“, und IDA liest es aus jedem weiteren Dokument dieser Art aus.
Eine Vorlage muss niemand von Hand bauen. Handschriftliche Einträge und angekreuzte Felder liest IDA mit.
E-Mails und Briefe: auslesen aus Fließtext
In E-Mails, Briefen und Berichten kann eine Information überall stehen. Auch hier liest IDA die Daten heraus, die Ihr Prozess braucht, etwa Absender, Datum oder IBAN, auch aus einem handschriftlichen Brief. Deterministisch: erkannt, nicht geraten.
Formulare und Fließtext im Vergleich
| Formulare und Rechnungen | E-Mails und Briefe | |
|---|---|---|
| Typische Dokumente | Formulare, Rechnungen, Anträge | E-Mails, Briefe, Berichte |
| Die Information steht | Immer an derselben Stelle | Irgendwo im Text |
Wo Entity Extraction zum Einsatz kommt
Rechnungen
Rechnungsnummer, Datum, Beträge, Steuer und Lieferant gehen direkt in die Buchhaltung, ohne dass jemand sie abtippt.
Verträge
Vertragsparteien, Beginn und Ende, Laufzeit und Zahlungsklauseln werden zu Daten. Fristen und Bedingungen lassen sich überwachen.
Kundenaufnahme
Banken und Versicherungen übernehmen Name, Geburtsdatum und Adresse aus Ausweisen und Antragsformularen in ihre Systeme.
E-Mails und Posteingang
Kontaktdaten, Bestellnummern und Anliegen werden aus eingehenden Nachrichten gelesen. Die Nachricht landet im richtigen Vorgang. Mehr dazu in unserem Blogbeitrag zum digitalen Posteingang.
Häufige Fragen
Was ist der Unterschied zwischen Entity Extraction und Named Entity Recognition?
Named Entity Recognition (NER) findet Entitäten in einem Text und ordnet ihnen eine Art zu, etwa Person oder Ort. Entity Extraction geht einen Schritt weiter und übergibt die Werte als strukturierte Daten an das nächste System.
Wie viele Beispiele braucht IDA?
Für Formulare und Rechnungen genügen wenige markierte Beispiele je Dokumentart.
Was passiert, wenn ein Wert unsicher ist?
IDA gibt jedem Wert einen Konfidenzwert. Werte unter dem Schwellenwert, den Sie festlegen, gehen zur Prüfung an einen Menschen.
Funktioniert Entity Extraction auch mit Handschrift?
Ja. IDA erkennt Handschrift mit einer Genauigkeit von über 95 %. Auch handschriftliche Formulare und Briefe lassen sich deshalb auslesen.
Mit Ihren Dokumenten ausprobieren
In einer Demo zeigen wir Ihnen, wie IDA in Ihren Dokumenten die Informationen findet, die Ihr Prozess braucht.