Die meisten Dokumente kommen als PDF. Die meiste Geschäftssoftware erwartet Daten. Dazwischen liegt die Dokumentenverarbeitung und die Frage, in welchem Format das Ergebnis vorliegen soll.
Die kurze Antwort: in beiden, weil Menschen und Systeme Unterschiedliches brauchen.
PDF: gemacht für Menschen
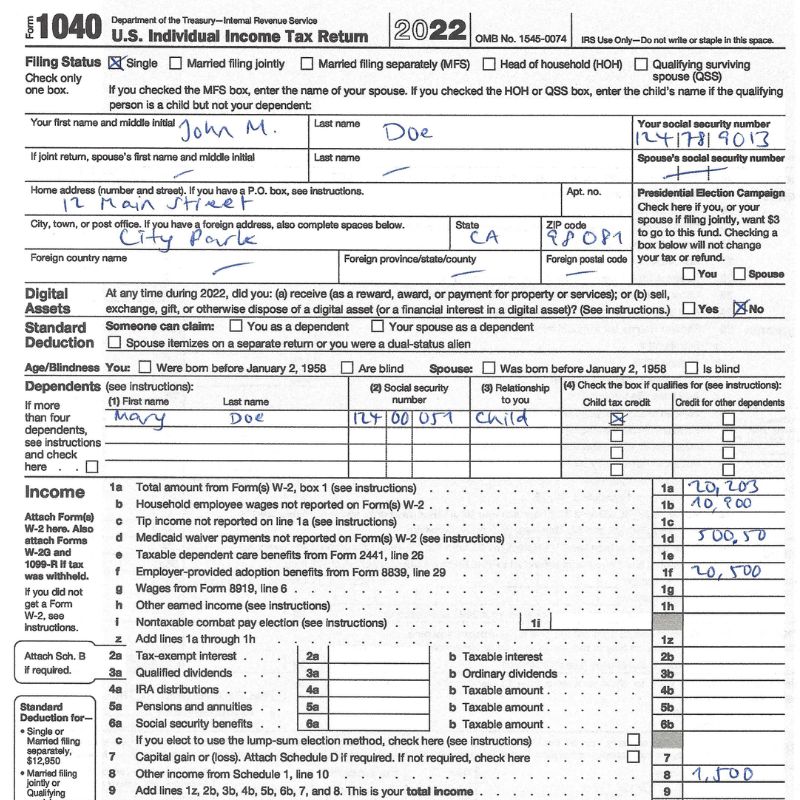
Ein PDF sieht auf jedem Bildschirm und jedem Drucker gleich aus. Deshalb ist es der Standard für Verträge, Rechnungen, Berichte und Formulare.
Was ein PDF nicht leistet: Es sagt einer Software nicht, was darin steht. In einem gescannten PDF ist der Text nur ein Bild. Selbst in einem digitalen PDF weiß ein Programm nicht, welche Zahl der Betrag ist und welche die Kundennummer.
JSON: gemacht für Systeme
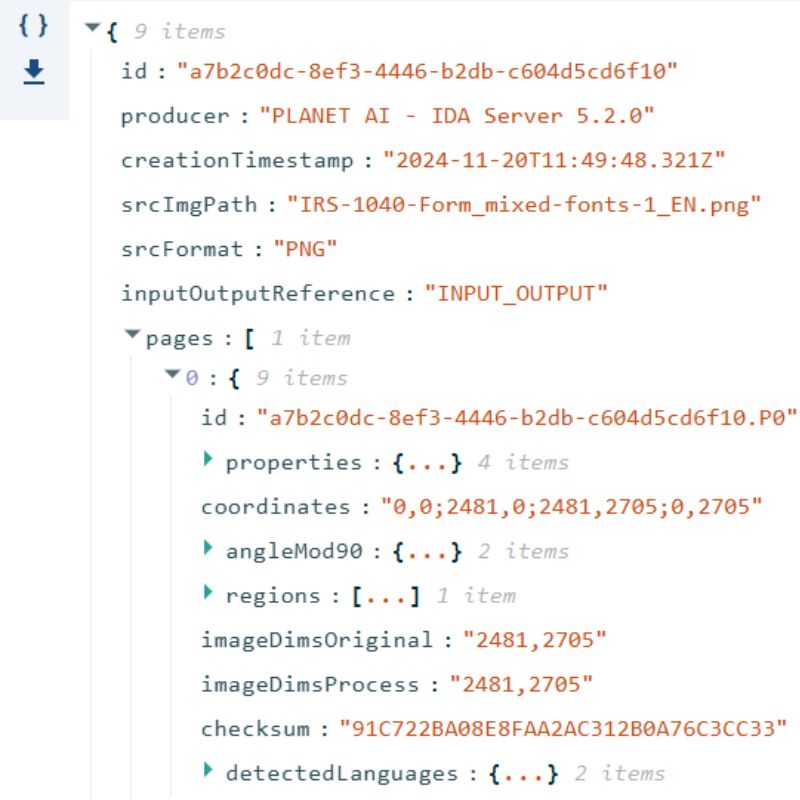
JSON (JavaScript Object Notation) ist ein Textformat für strukturierte Daten. Jeder Wert hat einen Namen: „Rechnungsnummer“: „2024-0815“. Fast jedes System und jede Schnittstelle (API) liest JSON direkt.
Was JSON nicht leistet: Es sieht nicht aus wie das Originaldokument. Für Menschen ist es schwer zu lesen.
PDF und JSON im Vergleich
| JSON | ||
|---|---|---|
| Gemacht für | Menschen | Systeme |
| Zeigt | Das Dokument, wie es aussieht | Die Daten, die darin stehen |
| Typischer Einsatz | Lesen, archivieren, versenden | Schnittstellen, Automatisierung, Auswertung |
| Für Software lesbar | Erst nach Texterkennung | Direkt |
Warum Dokumentenverarbeitung beides liefert
In der Dokumentenverarbeitung spielt das PDF zwei Rollen. Es ist der häufigste Eingang und ein nützliches Ergebnis.
IDA liest ein eingehendes PDF, klassifiziert es und holt die Daten als JSON heraus. Dieses JSON geht an die Fachanwendung, das ERP oder das DMS. Gleichzeitig kann IDA ein durchsuchbares PDF erzeugen, mit Textebene und den ausgelesenen Daten als Metadaten. Dieses PDF landet im Archiv, durchsuchbar und richtig abgelegt.
Bestehende Systeme bleiben, wie sie sind. Die Dokumentenverarbeitung liefert ihnen, was sie brauchen. Mehr zum Unterschied zwischen strukturierten und unstrukturierten Daten in unserem Blogbeitrag zu strukturierten Daten.
Häufige Fragen
Was ist JSON?
Ein Textformat für strukturierte Daten. Jeder Wert wird mit einem Namen gespeichert. Deshalb ist JSON der übliche Weg, Daten zwischen Systemen auszutauschen.
Was ist ein durchsuchbares PDF?
Ein PDF mit einer unsichtbaren Textebene über dem Bild. Die Seite sieht unverändert aus, aber Sie können den Text durchsuchen und kopieren.
Wann brauche ich PDF, wann JSON?
PDF, wenn Menschen das Dokument lesen, ablegen oder versenden. JSON, wenn ein System die Daten weiterverarbeitet.
Bekomme ich beides?
Ja. IDA liefert die ausgelesenen Daten als JSON und bei Bedarf ein durchsuchbares PDF für das Archiv.
Mit Ihren Dokumenten ausprobieren
In einer Demo zeigen wir Ihnen, wie IDA aus Ihren PDFs Daten macht und daraus wieder durchsuchbare PDFs.