Rechnungen, Verträge, Lieferscheine, Formulare: Die meisten Geschäftsinformationen kommen als Dokument. Menschen können sie lesen. Software kann es nicht, zumindest nicht ohne Hilfe.
Diese Lücke ist der Unterschied zwischen unstrukturierten und strukturierten Daten.
Strukturierte und unstrukturierte Daten
Strukturierte Daten haben ein festes Format. Jeder Wert hat einen Namen und einen Platz: Kundennummer, Betrag, Datum. Datenbanken, ERP-Systeme und Tabellen arbeiten mit strukturierten Daten.
Unstrukturierte Daten haben kein solches Format. Ein gescannter Brief, ein Vertrag als PDF oder das Foto eines Formulars enthalten dieselben Informationen, aber als Fließtext oder als Bild. Ein Programm erkennt nicht, wo der Betrag steht.
Formulare liegen dazwischen. Sie haben Felder, aber die Einträge sind oft handschriftlich oder angekreuzt.
Warum unstrukturierte Dokumente Prozesse bremsen
Solange Informationen in Dokumenten stecken, muss sie jemand von Hand übertragen. Das kostet Zeit und bringt Tippfehler. Und die Daten lassen sich erst durchsuchen, auswerten oder weitergeben, wenn sie eingetippt sind.
Wie aus Dokumenten strukturierte Daten werden
Dokumentenverarbeitung macht in drei Schritten aus Dokumenten strukturierte Daten:
- Die Texterkennung liest gedruckten und handschriftlichen Text, Tabellen, Barcodes und Ankreuzfelder.
- Die Klassifikation erkennt die Dokumentart.
- Die Extraktion holt die Werte heraus und gibt jedem einen Namen, zum Beispiel „Rechnungsnummer“ oder „Fälligkeit“.
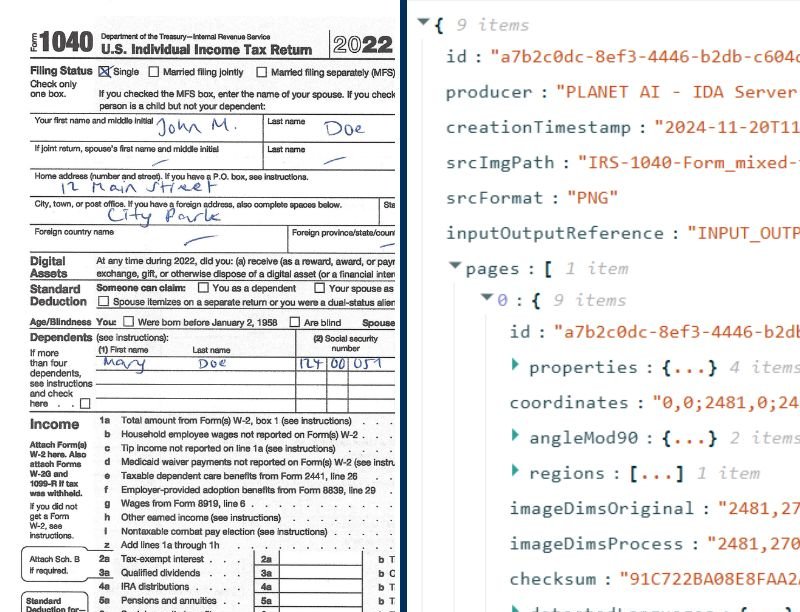
Links: ein Steuerformular als Scan oder PDF. Rechts: die Daten, die IDA daraus gelesen hat, als strukturiertes JSON. Jeder Wert lässt sich jetzt von Software weiterverarbeiten.
Mehr zu den einzelnen Schritten in unseren Blogbeiträgen zur digitalen Dokumentenerfassung und zur PDF-Klassifikation.
Ausgabeformate: PDF und JSON
IDA liefert die Ergebnisse in zwei Formaten, je nachdem, wo sie gebraucht werden.
Ein durchsuchbares PDF behält das Originaldokument und ergänzt eine Textebene. Menschen können es lesen, durchsuchen und im DMS ablegen.
JSON enthält die ausgelesenen Daten in strukturierter Form. Andere Systeme lesen es direkt, ohne dass jemand etwas abtippt.
Häufige Fragen
Was sind strukturierte Daten?
Daten in einem festen Format, bei dem jeder Wert einen Namen und einen Platz hat, etwa in einer Datenbank oder Tabelle.
Was sind unstrukturierte Daten?
Informationen ohne festes Format, etwa Fließtext in Briefen, Verträgen, E-Mails oder Scans. Menschen können sie lesen, Software ohne Hilfe nicht.
Warum JSON?
JSON ist ein verbreitetes Textformat für strukturierte Daten. Fast jedes System kann es lesen, deshalb ist es der übliche Weg, ausgelesene Daten zu übergeben.
Werden auch handschriftliche Einträge zu strukturierten Daten?
Ja. Die Handschrifterkennung liest handschriftliche Einträge in Formularen genauso wie gedruckten Text. IDA erkennt Handschrift mit einer Genauigkeit von über 95 %, Maschinenschrift mit über 99 %.
Mit Ihren Dokumenten ausprobieren
In einer Demo zeigen wir Ihnen, wie IDA aus Ihren Dokumenten strukturierte Daten macht.